Warum 16 Nullen die ehrlichste Zahl im Radar sind
Florian Berger · 15.09.2026
Das ai-discovery-radar misst jeden Monat, wie viele Websites einer festen Stichprobe von 30.000 Domains maschinenlesbare Discovery- und Consent-Dateien tatsächlich ausliefern — und seit heute steht offen, wie diese Zahlen entstehen. Der Technical Report v1.0 (DOI 10.5281/zenodo.22769680, CC BY 4.0) dokumentiert Klassifikation, Nennerregel, Stichprobe und Prüfverfahren so, dass jede veröffentlichte Quote nachvollzogen und angefochten werden kann.
Das ist kein Ergebnis-Papier. Es ist die Anleitung, um Ergebnisse richtig zu lesen — auch unsere eigenen.
Was „Adoption" hier heißt — und was nicht
Adoption bedeutet im Radar: Eine Route ist öffentlich abrufbar und die Antwort ist syntaktisch gültig. Mehr nicht. Ob irgendein Crawler die Datei liest, ob sie aktuell ist, ob sie etwas bewirkt — das misst das Radar nicht, und der Bericht sagt das im ersten Abschnitt.
Drei Lesarten schließt er ausdrücklich aus:
- „x % der Websites unterstützen KI-Discovery" — der Rahmen ist nicht das Web, und 34 benannte Wege sind nicht „KI-Discovery" im Allgemeinen.
- „Format X wird von x % genutzt" — Verfügbarkeit ist nicht Nutzung.
- „Die Adoption wächst" — zwei Messpunkte unter zwei Regelsätzen sind kein Trend.
Die sichere Form jeder Zahl lautet: x % der Hosts, die für diese Route in diesem Monat beobachtet werden konnten, auf Rahmen 2026-Q3.
Der Nenner ist die wichtigste Entscheidung
Ein Host, der die Messung mit einer Bot-Wall abweist, hat die Datei vielleicht. Ein Host, dessen robots.txt uns den Pfad verbietet, hat sie vielleicht. Wer beide als „nicht vorhanden" zählt, drückt jede Quote nach unten — und ungleichmäßig, weil Walls sich in den populären Rängen ballen.
Deshalb kennt das Radar sieben Zustände plus „nicht gemessen", und nur vier davon bilden den Nenner: vorhanden, Alias, Soft-404, abwesend. Blockiert, verboten, unerreichbar und nicht gemessen bleiben draußen. Diese Regel kam mit Regelsatz 0.3.0 und betraf rund ein Fünftel jedes Nenners; die August-Zahlen wurden daraufhin neu veröffentlicht. Das steht in der Versionsgeschichte — Fehler im Instrument werden dokumentiert, nicht still korrigiert.
Die 16 Nullen
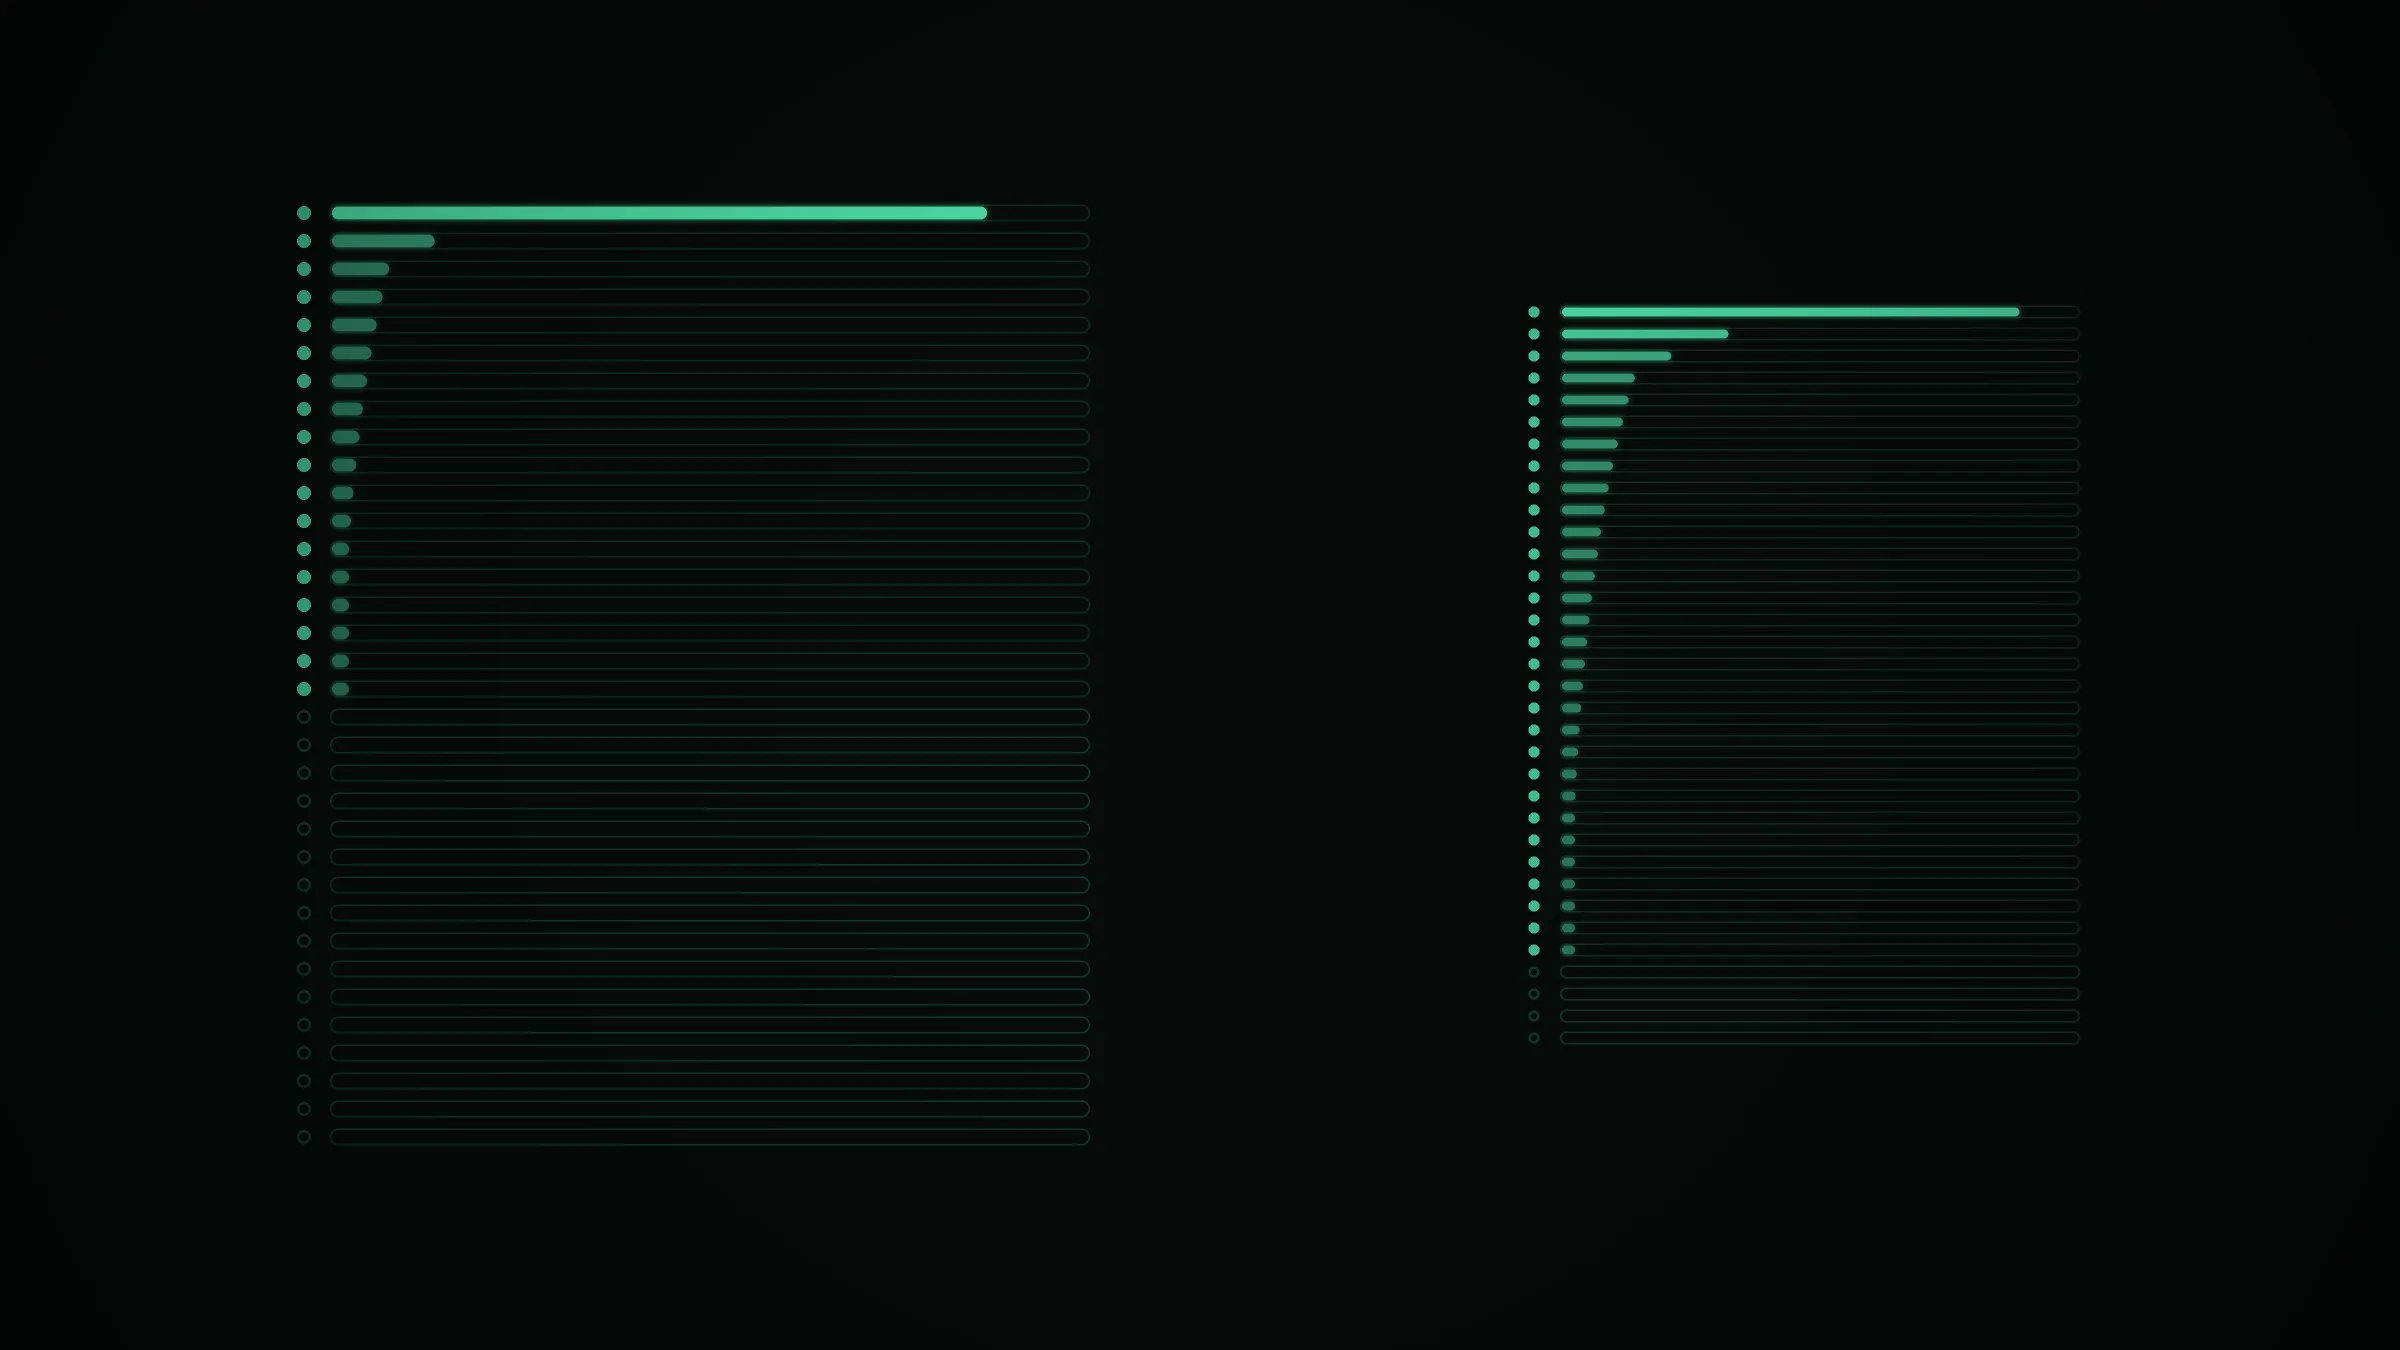
September 2026, Panel von 1.000 Domains (853 erreichbar): robots.txt 86,2 %, llms.txt 13,5 %, und 16 von 34 katalogisierten Wegen ohne einen einzigen Treffer.
Die Nullen sind das Ergebnis, nicht ein Messfehler — viele dieser Formate werden besprochen, als wären sie etabliert. Aber die Größe der Null hängt an der Stichprobe: Im zehnmal größeren Block desselben Monats (rund 9.700 Domains, davon 9.206 erreichbar) bleiben nur 4 von 34 Wegen bei null. Eine Null bei seltenen Routen auf 1.000 Domains ist ein Stichprobenboden. Wer sie als „Absenz" zitiert, zitiert falsch.
Konsequenz, entschieden am 15.09.: Ab dem Oktober-Lauf wächst das Panel auf 10.000 Domains, gezogen mit demselben Generator aus demselben eingefrorenen Rahmen; die 1.000er-Reihe läuft als Teilmenge weiter, damit August und September vergleichbar bleiben.
Vier Messfallen, die uns Daten gekostet haben
- Der HTTP-Status lügt. Große Plattformen antworten auf jeden Pfad mit 200. Ein Microblogging-Dienst liefert
{"ok":-100}für alles — gültiges JSON, keine Datei. Gültig ist erst, was den Pflichtschlüssel der Spezifikation trägt:{"gpc":true}ist eine Adoption,{"ok":-100}ein Fallback. - Bot-Walls antworten mit 404. Ohne Prüfung des Antwortkörpers sind sie von einem echten 404 nicht zu unterscheiden — und würden als „nicht adoptiert" zählen.
- Der Range-Header ist eine Falle. 454 Antworten mit 206, 311 ignoriert, etwa zehn Abbrüche in einem Pilotlauf. Ein Streaming-Limit tut denselben Dienst ohne Nebenwirkungen.
- Templates sehen aus wie Adoption. Ein Shop-System legt auf jedem Shop denselben Text in robots.txt, llms.txt, llms-full.txt und eine Agents-Datei — fünf Hosts, eine Vorlage, null Funde. Gleicher Wert auf jedem Host, der ihn trägt, ist eine Signatur, kein Fund.
Was der Bericht offen lässt — absichtlich
Die größte Unbekannte steht in einem eigenen Abschnitt: die Hosts hinter Walls. Beide Richtungen sind plausibel — wer in eine Bot-Wall investiert, publiziert vielleicht eher eine Policy für Maschinen (dann unterschätzt das offene Web die Adoption); oder die Wall ist die Policy (dann überschätzt es sie). Der Pilot kann das nicht trennen. Der Bericht nennt, was dafür fehlt: eine kalibrierte Wall-Quote je Schicht, ein breiteres Panel, und ein legitimer zweiter Kanal — erklärte Kooperation mit Betreibern, nie Umgehung.
Und er sagt, was noch niemand geprüft hat: Die Nachrechnung vor jeder Veröffentlichung ist eine interne Kontrolle, kein externes Audit. Die Roharchive bleiben privat, weil sie Antwortkörper und damit personenbezogene Daten enthalten. Was veröffentlicht ist, sind Protokoll, Prüfsummen und Verfahren — genug, um die Methode zu prüfen und eine Neuauswertung zu verlangen, nicht genug, um den Klassifikator selbst laufen zu lassen. Auch das steht so im Bericht.
Warum wir das tun
Wir bauen Websites, die von Menschen und von KI-Systemen gefunden werden sollen. btlabs Core liefert einige der gemessenen Wege serienmäßig aus — genau deshalb ist der Interessenkonflikt im Bericht als Tabelle aufgeführt, Bedenken gegen Gegenmaßnahme. Regelsatz eingefroren und versioniert, alle Routen veröffentlicht, auch die bei null; keine Einzeldomain im Ergebnis.
Zahlen statt Annahmen. Wer eine davon anzweifelt, findet das Verfahren offen dokumentiert — und kann eine Neuauswertung verlangen.
Links: Technical Report v1.0 — doi.org/10.5281/zenodo.22769680 · Datensatz (Concept-DOI) — doi.org/10.5281/zenodo.22178282 · Radar-Seite mit Zitierkarte: /de/ai-discovery-radar · Repository: github.com/flober81/ai-discovery-radar
Häufig gestellte Fragen.
Was misst das ai-discovery-radar?
Das ai-discovery-radar misst monatlich, wie viele Websites einer eingefrorenen Stichprobe von 30.000 Domains 34 katalogisierte maschinenlesbare Discovery- und Consent-Dateien tatsächlich ausliefern — etwa robots.txt, llms.txt, TDMRep oder Agent-Cards. Gezählt wird Verfügbarkeit, nicht Nutzung.
Warum zählen Bot-Walls nicht als „nicht vorhanden"?
Ein Host, der die Messung abweist, kann die Datei haben. Blockierte, verbotene und unerreichbare Hosts bleiben deshalb aus jedem Nenner draußen; die Adoptionsquote gilt nur für beobachtbare Hosts.
Bedeutet 0 % im Panel, dass niemand das Format nutzt?
Nein. Bei seltenen Routen ist eine Null auf 1.000 Domains ein Stichprobenboden: Im zehnmal größeren Block desselben Monats bleiben nur 4 statt 16 Wege bei null. Ab dem Oktober-Lauf 2026 wächst das Panel deshalb auf 10.000 Domains.
Wo ist die Methode dokumentiert?
Im Technical Report v1.0 auf Zenodo (DOI 10.5281/zenodo.22769680, CC BY 4.0): Klassifikationsmodell, Nennerregel, Stichprobendesign, Prüfverfahren und Messfallen.
Kann meine Domain ausgeschlossen werden?
Ja, ohne Rückfrage und ohne Begründung: eine E-Mail mit der Domain, ein Issue im Repository oder eine Disallow-Zeile für das Token ai-discovery-radar in der robots.txt. Ausgeschlossene Domains werden übersprungen, bevor eine Anfrage gestellt wird.