Perché sedici zeri sono la cifra più onesta del radar
Florian Berger · 15 set 2026
L'ai-discovery-radar misura ogni mese quanti siti di un campione fisso di 30.000 domini mettono davvero a disposizione file di discovery e consenso leggibili dalle macchine — e da oggi è pubblico come nascono quei numeri. Il Technical Report v1.0 (DOI 10.5281/zenodo.22769680, CC BY 4.0) documenta classificazione, regola del denominatore, campionamento e procedura di verifica in modo che ogni quota pubblicata possa essere ricostruita e contestata.
Non è un documento di risultati. È l'istruzione per leggere i risultati nel modo giusto — anche i nostri.
Che cosa significa qui «adozione» — e che cosa no
Nel radar adozione significa: una rotta è raggiungibile pubblicamente e la risposta è sintatticamente valida. Nient'altro. Se un crawler legga davvero quel file, se sia aggiornato, se produca un effetto — il radar non lo misura, e il rapporto lo dice nel primo paragrafo.
Tre letture le esclude esplicitamente:
- «il x % dei siti supporta la discovery IA» — il perimetro non è il web, e 34 rotte nominate non sono «discovery IA» in generale.
- «il formato X è usato dal x %» — disponibilità non è utilizzo.
- «l'adozione cresce» — due punti di misura sotto due versioni di regolamento non sono una tendenza.
La forma sicura di ogni cifra è: x % degli host osservabili per questa rotta nella rilevazione di questo mese, sul perimetro 2026-Q3.
Il denominatore è la decisione più importante
Un host che respinge la misurazione con un bot wall il file potrebbe averlo. Un host il cui robots.txt ci vieta il percorso potrebbe averlo. Chi conta entrambi come «non presente» abbassa ogni quota — e in modo disomogeneo, perché i wall si concentrano nelle posizioni più popolari.
Per questo il radar conosce sette stati più «non misurato», e solo quattro formano il denominatore: presente, alias, soft-404, assente. Bloccato, vietato, irraggiungibile e non misurato restano fuori. Questa regola è arrivata con il regolamento 0.3.0 e ha riguardato circa un quinto di ogni denominatore; i numeri di agosto sono stati ripubblicati. Sta nello storico delle versioni — gli errori dello strumento vengono documentati, non corretti in silenzio.
I sedici zeri
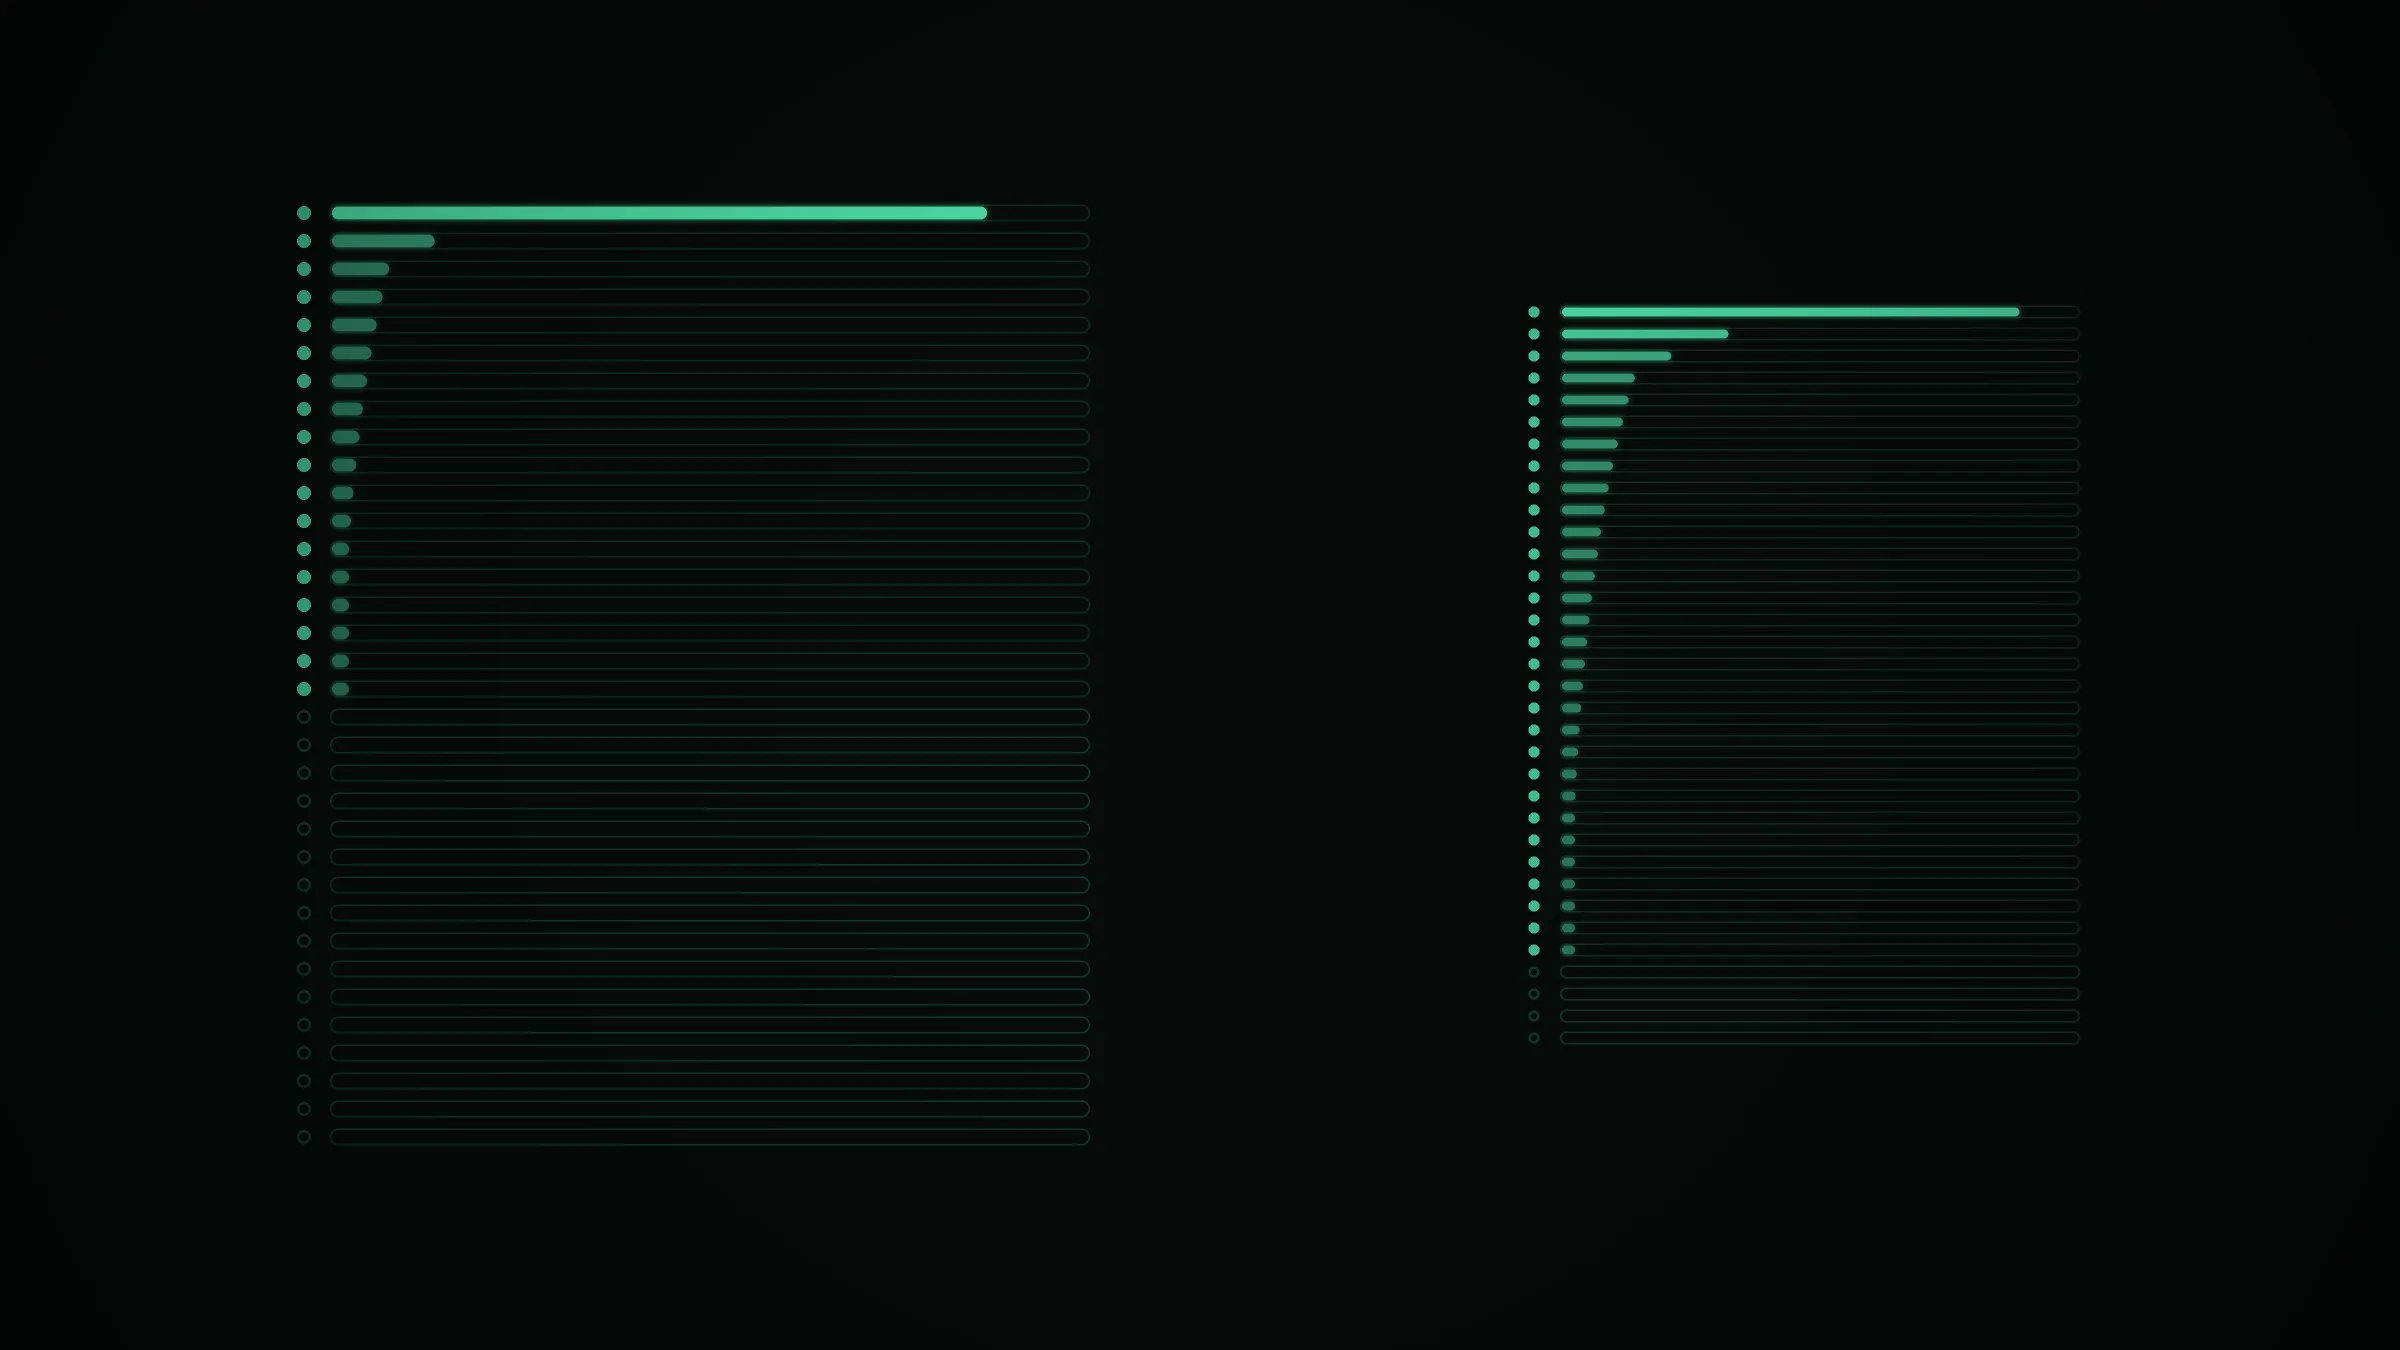
Settembre 2026, panel di 1.000 domini (853 raggiungibili): robots.txt 86,2 %, llms.txt 13,5 %, e 16 rotte su 34 senza un solo riscontro.
Gli zeri sono il risultato, non un errore di misura — molti di questi formati vengono discussi come se fossero affermati. Ma la dimensione dello zero dipende dal campione: nel blocco dieci volte più grande dello stesso mese (circa 9.700 domini, di cui 9.206 raggiungibili) restano a zero solo 4 rotte su 34. Uno zero su rotte rare a 1.000 domini è un limite del campione. Chi lo cita come «assenza» cita male.
Conseguenza, decisa il 15.09.: dalla rilevazione di ottobre il panel cresce a 10.000 domini, estratti con lo stesso generatore dallo stesso perimetro congelato; la serie da 1.000 prosegue come sottoinsieme, così agosto e settembre restano confrontabili.
Quattro trappole di misura che ci sono costate dati
- Lo stato HTTP mente. Grandi piattaforme rispondono 200 a qualunque percorso. Un servizio di microblogging restituisce
{"ok":-100}per tutto — JSON valido, nessun file. È valido solo ciò che porta la chiave obbligatoria della specifica:{"gpc":true}è un'adozione,{"ok":-100}un ripiego. - I bot wall rispondono 404. Senza un controllo del corpo della risposta sono indistinguibili da un 404 autentico — e conterebbero come «non adottato».
- L'header Range è una trappola. 454 risposte con 206, 311 lo hanno ignorato, una decina di interruzioni in una rilevazione pilota. Un limite di streaming fa lo stesso lavoro senza effetti collaterali.
- I template sembrano adozione. Una piattaforma e-commerce mette su ogni negozio lo stesso testo in robots.txt, llms.txt, llms-full.txt e un file agents — cinque host, un template, zero riscontri. Lo stesso valore su ogni host che lo porta è una firma, non un ritrovamento.
Che cosa il rapporto lascia aperto — di proposito
L'incognita più grande ha una sezione propria: gli host dietro i wall. Entrambe le direzioni sono plausibili — chi investe in un bot wall forse pubblica più facilmente una policy per le macchine (allora il web aperto sottostima l'adozione); oppure il wall è la policy (allora la sovrastima). Il pilota non sa distinguerle. Il rapporto dice che cosa servirebbe: una quota di wall calibrata per strato, un panel più ampio e un secondo canale legittimo — cooperazione dichiarata con i gestori, mai aggiramento.
E dice anche che cosa nessuno ha ancora verificato: il ricalcolo prima di ogni pubblicazione è un controllo interno, non un audit esterno. Gli archivi grezzi restano privati, perché contengono corpi di risposta e quindi dati personali. Ciò che è pubblicato sono protocollo, checksum e procedura — abbastanza per esaminare il metodo e chiedere una nuova valutazione, non abbastanza per far girare da soli il classificatore. Anche questo sta scritto nel rapporto.
Perché lo facciamo
Costruiamo siti che devono essere trovati da persone e da sistemi IA. btlabs Core mette a disposizione di serie alcune delle rotte misurate — proprio per questo il conflitto di interessi è riportato nel rapporto come tabella, obiezione contro contromisura. Regolamento congelato e versionato, tutte le rotte pubblicate, anche quelle a zero; nessun dominio singolo nel risultato.
Numeri al posto di supposizioni. Chi ne mette in dubbio uno trova la procedura documentata apertamente — e può chiedere una nuova valutazione.
Link: Technical Report v1.0 — doi.org/10.5281/zenodo.22769680 · Dataset (concept DOI) — doi.org/10.5281/zenodo.22178282 · Pagina del radar con scheda di citazione: /it/ai-discovery-radar · Repository: github.com/flober81/ai-discovery-radar
Domande frequenti.
Che cosa misura l'ai-discovery-radar?
L'ai-discovery-radar misura ogni mese quanti siti di un campione congelato di 30.000 domini forniscono davvero 34 file di discovery e consenso catalogati e leggibili dalle macchine — per esempio robots.txt, llms.txt, TDMRep o agent card. Si conta la disponibilità, non l'uso.
Perché i bot wall non contano come «file assente»?
Un host che respinge la misurazione può comunque avere il file. Host bloccati, vietati e irraggiungibili restano quindi fuori da ogni denominatore: il tasso di adozione vale solo per gli host osservabili.
Uno 0 % nel panel significa che nessuno usa quel formato?
No. Per le rotte rare uno zero su 1.000 domini è un limite del campione: nel blocco dieci volte più grande dello stesso mese restano a zero solo 4 rotte invece di 16. Dalla rilevazione di ottobre 2026 il panel cresce perciò a 10.000 domini.
Dove è documentato il metodo?
Nel Technical Report v1.0 su Zenodo (DOI 10.5281/zenodo.22769680, CC BY 4.0): modello di classificazione, regola del denominatore, disegno del campione, procedura di verifica e trappole di misura.
Posso far escludere il mio dominio?
Sì, senza domande e senza motivazione: una e-mail con il dominio, una issue nel repository oppure una riga Disallow per il token ai-discovery-radar nel file robots.txt. I domini esclusi vengono saltati prima che venga inviata una richiesta.